Los errores de traducción automática no siempre resultan evidentes. Una salida puede ser gramaticalmente correcta y cambiar una cifra, omitir una condición, escoger un término incorrecto o sonar impropia para el mercado. El control debe adaptarse al contenido y a las consecuencias del fallo.
Por qué una traducción fluida puede estar equivocada
Los sistemas de traducción predicen una salida plausible a partir del contexto disponible. No conocen automáticamente la versión aprobada de un dato, la terminología de la empresa ni la intención comercial. Por eso, la fluidez no demuestra fidelidad ni adecuación.
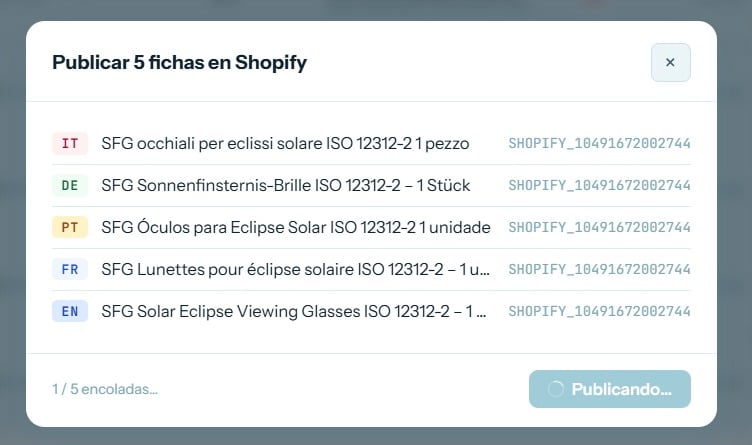
Dentro de un sistema de contenidos con IA, la traducción se conecta con fuentes, glosarios, reglas y controles antes de llegar a publicación.
1. Cambios de significado
Una negación, una relación causal o una condición pueden alterarse aunque la frase resultante suene natural. Compara las afirmaciones, no solo las palabras. Presta atención a instrucciones, excepciones y lenguaje que expresa obligación o posibilidad.
2. Omisiones
Los segmentos repetitivos, listas, notas, variables y frases largas pueden perder elementos. Utiliza controles de completitud y revisa que cada campo obligatorio exista en la versión traducida.
3. Terminología inconsistente
Un mismo concepto puede aparecer con varias traducciones válidas que confunden al público o contradicen el producto. El glosario debe incluir contexto, término preferido, variantes y formas prohibidas.
4. Números, unidades y formatos
Fechas, decimales, monedas, tallas y unidades necesitan controles específicos. No basta con conservar la cifra: hay que verificar convención local, conversión cuando proceda y relación con el atributo correcto.
5. Datos o atributos inventados
Los modelos generativos pueden completar huecos con información plausible. Si la fuente no confirma un material, una compatibilidad o un beneficio, la traducción debe señalar la ausencia en lugar de convertirla en un claim.
6. Voz de marca diluida
El resultado puede ser correcto y sonar intercambiable. Revisa formalidad, ritmo, vocabulario, nivel de persuasión y relación con otros contenidos del mercado. La voz debe expresarse mediante reglas y ejemplos, no únicamente con adjetivos como “cercana” o “premium”.
7. Calcos y referencias culturales
Metáforas, humor, tratamientos, llamadas a la acción y referencias locales requieren adaptación. Traducir literalmente puede producir una frase comprensible pero poco natural o inadecuada.
8. Errores SEO/GEO
Traducir keywords directamente puede desalinear el contenido respecto de la demanda local. También puede crear titles similares a otras URLs, anchors pobres o respuestas que no coinciden con la intención asignada.
9. Variables y HTML dañados
Etiquetas, placeholders, nombres de campos y fragmentos de código pueden modificarse. Añade validaciones automáticas para estructura, variables, enlaces y límites del canal antes de revisar estilo.
10. Nivel de revisión insuficiente
Aplicar el mismo control a todo el volumen es ineficiente y arriesgado. Clasifica contenido según visibilidad, regulación, impacto comercial, sensibilidad y reversibilidad. El marco de control humano para contenido con IA ayuda a definir responsables y escalado.
Checklist antes de publicar
- Contrastar hechos, cifras y claims con la fuente.
- Verificar que no falten segmentos ni campos.
- Aplicar glosario y convenciones locales.
- Revisar naturalidad, voz e intención.
- Comprobar HTML, variables, enlaces y metadatos.
- Asignar revisión humana según el riesgo.
- Registrar errores para actualizar reglas y fuentes.
Cómo combinar controles automáticos y revisión humana
La automatización detecta patrones: términos no permitidos, números alterados, omisiones, etiquetas o longitudes. Los especialistas validan sentido, naturalidad, cultura, persuasión y consecuencias.
La validación semántica multilingüe ofrece un método específico para revisar significado y terminología. Para una evaluación más amplia de hechos, formato y trazabilidad, consulta la checklist de contenido generado por IA.
Preguntas frecuentes sobre errores de traducción automática
¿Qué error es más peligroso en una traducción automática?
Depende del contenido, pero los errores que cambian cifras, obligaciones, nombres de producto o instrucciones suelen tener mayor riesgo que un fallo estilístico. Por eso la revisión debe priorizar impacto y contexto, no solo fluidez.
¿La revisión humana corrige todos los errores de la IA?
No basta con revisar al final. La revisión humana debe comprobar significado, terminología, formato, tono y adecuación cultural, y sus hallazgos deben volver al glosario, las reglas y el flujo de trabajo.
¿Cómo se puede reducir el riesgo antes de publicar?
Define el nivel de revisión según el riesgo, valida nombres y datos con fuentes fiables, comprueba las etiquetas y variables, y registra los errores recurrentes para mejorar el proceso en la siguiente entrega.
El objetivo es evitar que el error se repita
Corregir una pieza resuelve una incidencia. Registrar su causa permite mejorar el glosario, la fuente, el prompt, la plantilla o el nivel de revisión. Esa retroalimentación convierte la traducción con IA en un proceso más consistente.
Si necesitas traducir grandes volúmenes con terminología, QA y revisión proporcional al riesgo, consulta nuestro servicio de traducción asistida por IA.